Ces dernières années ont vu une accélération massive de l’utilisation de l’IA dans le développement d’exploits offensifs. Et alors que le temps nécessaire pour exploiter une vulnérabilité continue de se réduire, les administrateurs reçoivent une seule consigne : corriger plus vite.
Mais ce n’est jamais aussi simple. Un correctif peut réparer, mais il peut aussi casser. Avant le déploiement, il faut donc être suffisamment confiant quant à la stabilité du correctif. Tiendra-t-il en production, ou mettra-t-il 10 000 personnes hors ligne un mardi ?
Les vulnérabilités apparaissent presque tous les jours, et le temps dont vous disposez pour examiner chacune d’elles ne cesse de diminuer. Il faut examiner le correctif, décider s’il est stable, puis le déployer. Faire ces trois étapes manuellement — alors que le volume de vulnérabilités continue d’augmenter — ne laisse que deux options : soit ajouter plus de personnel, ce qui n’est pas évolutif, soit trouver un moyen de le faire de manière autonome. C’est là qu’intervient la gestion autonome des correctifs (APM – Autonomous Patch Management).
L’APM ne retire pas les humains de l’équation. Au contraire, elle rend le technicien plus rapide en lui fournissant de meilleures informations pour de meilleures décisions, réduisant ainsi le temps consacré à chaque correctif.
Assurer la stabilité des correctifs
De meilleures informations aident à distinguer les correctifs stables des instables. Le fournisseur du correctif a-t-il historiquement fourni des correctifs stables ? Existe-t-il des métriques de benchmarking publiques attestant de la stabilité ? Disposez-vous d’informations de performance basées sur des signaux tels que la télémétrie des endpoints et les plantages d’applications, collectés dans votre propre environnement ou auprès de vos pairs utilisant le même fournisseur de gestion des correctifs ?
Aujourd’hui, ces métriques sont intégrées dans un score de fiabilité qui aide les administrateurs informatiques à évaluer la situation. Bien que les scores de fiabilité soient un excellent indicateur de stabilité, ils ne sont qu’un indicateur. Ils ne garantissent pas une précision de 100 %.
Les administrateurs informatiques doivent donc toujours tester les correctifs dans un groupe de test et attendre de voir ce qui casse et quand. Bien qu’il s’agisse d’une méthode plus précise pour garantir la stabilité, elle comporte ses propres problèmes : le banc d’essai doit reproduire l’environnement de production réel, qui est large et désordonné, et non une poignée d’appareils critiques.
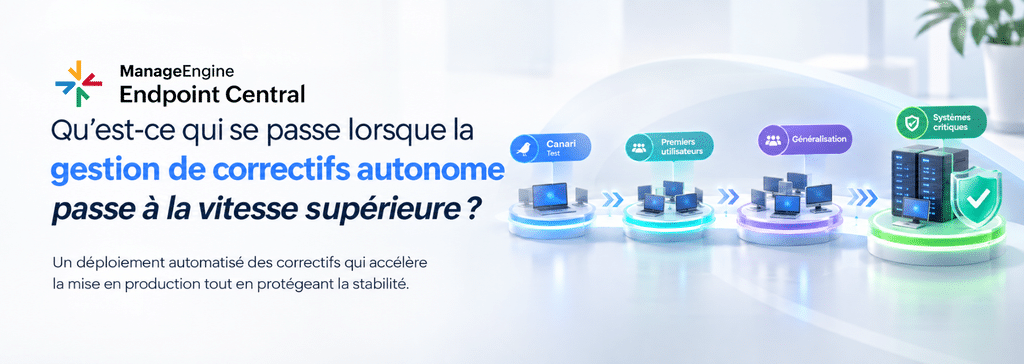
Au lieu de définir manuellement les anneaux de déploiement et les calendriers de déploiement, l’APM détermine les deux de manière dynamique en fonction de vos préférences.
Elle regroupe ensuite les endpoints en fonction du risque et du comportement des appareils. L’anneau canari comprend des appareils non critiques qui sont vulnérables, se corrigent rapidement et ont un historique de redémarrages stables, ce qui permet de détecter tôt les problèmes évidents. L’anneau des early adopters élargit les tests à un mélange diversifié de configurations d’endpoints tout en excluant encore les systèmes critiques pour l’entreprise. La population générale suit après une validation réussie. Enfin, l’anneau critique — serveurs de production, appareils des dirigeants et autres systèmes critiques pour l’entreprise — ne reçoit les correctifs qu’après qu’ils aient été validés dans tous les anneaux précédents.
Assurer une interruption minimale pour les utilisateurs
Il est vrai qu’un mauvais déploiement de correctifs provoque des perturbations. Mais tout déploiement de correctifs qui perturbe les utilisateurs en plein milieu de leur travail provoque également de la frustration. Dans un scénario idéal, l’utilisateur final ne devrait pas ressentir l’impact de ce que vous faites sur ses appareils.
Avec l’APM, vous pouvez déployer les correctifs auprès des utilisateurs lorsqu’ils sont inactifs, plutôt que lorsqu’ils sont en plein milieu de quelque chose. Le déploiement pendant les temps d’inactivité est un véritable changement de donne pour garantir que la productivité des utilisateurs n’est pas perturbée. Si ce n’est pas quelque chose que vous pouvez faire aujourd’hui, donnez-leur un portail en libre-service et laissez-les récupérer les correctifs quand cela leur convient.
Vous pouvez déployer vos correctifs de manière entièrement autonome en arrière-plan, les appliquer pendant les temps d’inactivité, ou laisser le choix aux utilisateurs. Dans tous les cas, l’expérience s’améliore ou reste invisible. Elle ne se dégrade jamais.
C’est l’APM telle que nous la connaissons aujourd’hui. Bien qu’elle ait aidé les équipes à passer de cycles de correctifs de plusieurs mois à des cycles de quelques jours, votre équipe de sécurité vous dira toujours de corriger plus vite. Car dans le paysage des menaces actuel, même quelques jours constituent une fenêtre d’exploitation suffisamment large pour un attaquant.
Mais en réalité, pour vraiment mesurer la stabilité des correctifs et garantir une perturbation minimale, il faut attendre — attendre que le temps d’inactivité des employés ouvre la fenêtre de correctifs, attendre que les employés récupèrent les correctifs depuis le portail en libre-service, attendre que les employés reprennent leur routine le lendemain et signalent d’éventuels problèmes après un déploiement. C’est votre boucle de feedback actuelle. Le plus rapide que vous puissiez espérer est d’au moins 24 heures. Dans d’autres cas, cela peut s’étendre sur des semaines.
Amplifier votre APM
Comment rendre ce processus plus rapide ? Aujourd’hui, ce qui freine les équipes dans un déploiement plus rapide, c’est le test. La question que vous devriez donc vous poser est : « Comment tester plus vite, sans compromettre la qualité de l’évaluation ? »
Supposons que vous capturez l’activité réelle des employés, leurs routines quotidiennes qui aident à signaler les problèmes d’un correctif déployé. Rejouez-la dans un bac à sable qui reproduit votre environnement de production : une configuration virtuelle avec une réplique exacte de vos appareils de production et de votre mix d’applications. Vous pouvez faire tourner 24 heures de comportement de ces machines en quelques minutes. Une véritable dilatation du temps se produit : vous obtenez la décision, qui aurait normalement pris au moins 24 heures, en quelques minutes.
Cet exercice de simulation réduit véritablement le temps nécessaire pour vérifier la stabilité des correctifs de plusieurs jours à quelques minutes. C’est là que l’APM devrait évoluer.
Aujourd’hui, de nombreuses équipes informatiques retardent les déploiements de correctifs par crainte des conséquences d’une perturbation. Si l’on regarde les choses objectivement, un mauvais déploiement de correctifs provoque certes une perturbation — mais il s’agit uniquement d’une perturbation interne. Elle ne fuit pas de données clients. Elle ne ternit pas les réputations.
Plus vos systèmes restent non corrigés, plus le risque est élevé pour votre organisation. Dommages réputationnels, pertes financières, retombées sur la chaîne d’approvisionnement : ce sont des choses dont une entreprise ne se remet pas.
Ainsi, lorsque l’APM monte en puissance, la partie opérationnelle du cycle de correctifs s’accélère sans provoquer de perturbations. Vous corrigez assez vite pour rester en sécurité — et suffisamment en sécurité pour continuer à fonctionner.
Source : https://www.manageengine.com/products/desktop-central/endpoint-edge/levelling-up-autonomous-patch-management.html